Kontrollgruppe im CRM: Wie ein Versanddienst den Effekt von Kampagnen um das 16-Fache überschätzte und wie Sie Ihren Bericht prüfen
Ein realer Fall: Die erste Schätzung der CRM-Kampagnen ergab +77 %, die korrekte nach der ursprünglichen Zufallsaufteilung +4,8 %. Wo Kontrollgruppen brechen und 7 Prüfungen.
Kurz gesagt
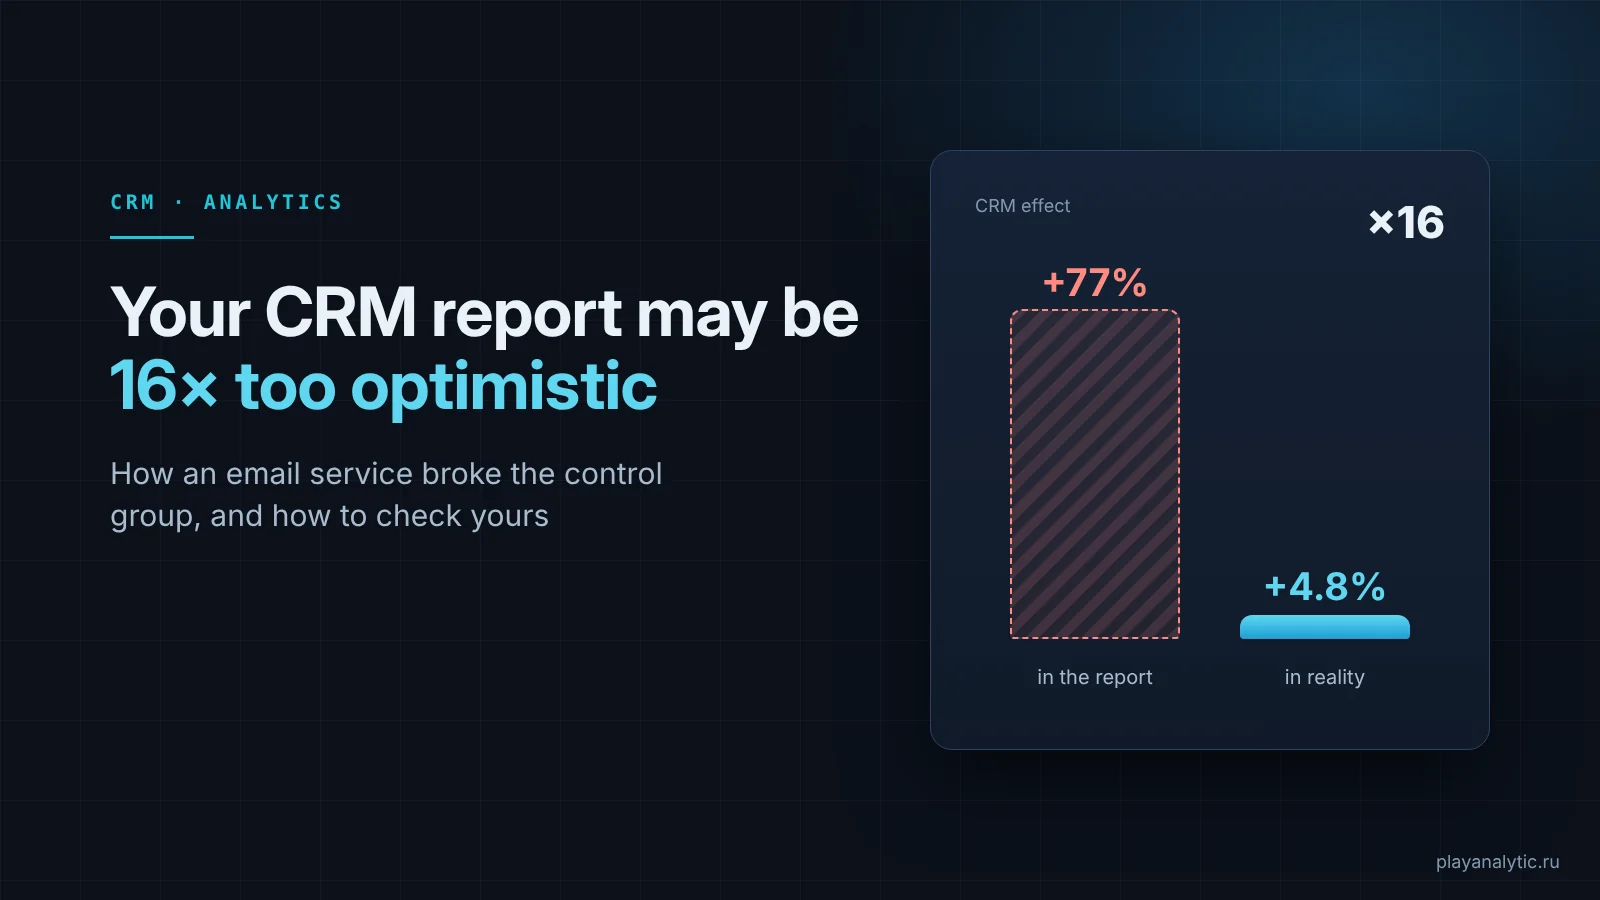
- Die erste Schätzung der CRM-Kampagnen einer Handelskette ergab +77 % Kauf-Conversion. Die korrekte Schätzung nach der ursprünglichen Zufallsaufteilung: +4,8 %. Ein Unterschied um das 16-Fache.
- Die Formel war richtig. Der Versanddienst hat inaktive Kunden aus der Testgruppe aussortiert, die Kontrollgruppe aber kaum angetastet. Verglichen wurden also „aktive“ Kunden mit „allen“.
- Statistische Signifikanz erkennt diesen Fehler nicht. Unten: wie man den Effekt neu berechnet, wie Sie Ihren Bericht in einer Stunde prüfen und 7 Prüfungen vor einer Budgetentscheidung.
Warum ein Kampagnenbericht den Effekt überschätzen kann
Eine Handelskette mit Onlineshop kam zu uns. Das Team hatte den Effekt der CRM-Kampagnen berechnet und +77 % Kauf-Conversion erhalten. Auf dieser Zahl baute bereits ein Plan auf: mehr, breiter und häufiger versenden.
Wir haben die Berechnung geprüft und +4,8 % erhalten. Niemand hatte Daten geschönt, die Formel stimmte, es gab eine Kontrollgruppe, und die Aufteilung war zufällig. Der Fehler entstand an einer Stelle, an die Analysten selten denken: beim Hochladen der Kunden in den Versanddienst.
Fazit für das Business: Bevor Sie das CRM-Budget erhöhen, prüfen Sie, wie der Effekt berechnet wurde. Ein Unterschied um das 16-Fache ist keine Rundungsfrage, sondern eine andere Entscheidung.
Wozu CRM eine Kontrollgruppe braucht
Manche Kunden hätten ohnehin gekauft. Ein Stammkunde kommt am Freitag, auch wenn er am Donnerstag keine SMS bekommen hat. Rechnet man diesen Kauf der Kampagne zu, sieht der Bericht gut aus, während das Geld für SMS verloren ist.
Die Kontrollgruppe sind Kunden, die bewusst nichts erhalten. Der Unterschied bei den Käufen zwischen ihnen und den Empfängern ist der inkrementelle Effekt der Kampagnen, der Uplift. Dieselbe Frage, „was wäre ohne uns passiert“, steht auch hinter einem Attributions-Audit der Werbekanäle.
Fazit für das Business: Ohne Kontrollgruppe bezahlen Sie auch für Käufe, die ohnehin passiert wären.
Wie wir den Test aufgesetzt haben: eine globale Kontrollgruppe
Ziel war zu verstehen, wie viel alle CRM-Kanäle zusammen (SMS, Push und E-Mail) über die Käufe hinaus bringen, die Kunden ohnehin getätigt hätten.
Dafür haben wir eine globale Kontrollgruppe entworfen: Kunden, die einen ganzen Monat lang über keinen Kanal etwas erhalten. So sieht man den Effekt des gesamten CRM statt einer einzelnen Kampagne, die sich mit allen anderen überschneidet.
Die Basis wurde zufällig 50 zu 50 aufgeteilt. Vor dem Start haben wir die Balance geprüft: Die Gruppen müssen vor der ersten Nachricht eine ähnliche Kaufhistorie haben. Hat eine Gruppe von Anfang an mehr aktive Kunden, ist das Ergebnis von vornherein verzerrt.
Alles lief nach Lehrbuch. Doch die Balanceprüfung betrachtet die Gruppen im Moment der Aufteilung, und Tests brechen oft später. Mehr dazu, wie wir solche Experimente planen, auf der Seite A/B-Tests und Experimente.
Fazit für das Business: Ein korrektes Testdesign garantiert keine korrekte Zahl. Prüfen Sie den gesamten Datenweg, von der Aufteilung bis zum Bericht.
Wo die Kontrollgruppe bricht
Vor dem Versand werden Kunden in den Versanddienst geladen, der aussortiert, wen man nicht anschreiben darf oder sollte: ohne Einwilligung, mit ungültiger Telefonnummer oder E-Mail, abgemeldet. Genau das soll der Dienst tun.
Die Kontrollgruppe erhielt aber nichts, deshalb durchlief sie die vollständige Prüfung nie und wurde nur nach Grundregeln bereinigt. Danach waren die Gruppen nicht mehr gleich: Aus der Testgruppe fielen 52 % der Kunden heraus, aus der Kontrollgruppe nur 18 %. Und es fielen nicht zufällige Kunden heraus, sondern weniger aktive.
In der Testgruppe blieben Kunden mit Einwilligung, funktionierenden Kontakten und ohne Abmeldung. Sie kaufen ohnehin häufiger. In der Kontrollgruppe blieben die inaktiven Kunden. Die erste Schätzung verglich alle, die der Dienst behalten hatte, mit der gesamten Kontrollgruppe. Daher +77 %. Das ist nicht der Unterschied zwischen „angeschrieben“ und „nicht angeschrieben“, sondern zwischen aktiven Kunden und allen.
Eine solche Zahl wirkt plausibel, und ein Signifikanztest erkennt sie nicht. Signifikanz sagt, dass der Unterschied nicht zufällig ist, aber nicht, woher er kommt. Hier kam er vom Filter. Und ein großes Plus macht selten jemanden misstrauisch: Man hinterfragt schlechte Zahlen, nicht gute.
Fair vergleichen kann man die Gruppen auf zwei Wegen: vollständig, so wie sie aufgeteilt wurden, oder beide Gruppen schon vor der Aufteilung gleich filtern.
Fazit für das Business: Der Fehler steckt nicht in der Formel, sondern im Weg der Daten durch den Versanddienst. Vergleicht ein Bericht die vom Dienst behaltenen Kunden mit der gesamten Kontrollgruppe, ist der Effekt sehr wahrscheinlich überschätzt.
Wie man den Effekt neu berechnet: Vergleich nach der ursprünglichen Aufteilung
Wir sind zur ursprünglichen Zufallsaufteilung zurückgekehrt und haben alle der Testgruppe Zugeordneten mit allen der Kontrollgruppe Zugeordneten verglichen, einschließlich derer, die der Dienst aussortiert hatte und die nie eine Nachricht erhielten. In der Statistik heißt das Intention-to-treat.
Warum Menschen mitzählen, die nichts erhalten haben? Nur so bleiben die Gruppen in allem außer den Kampagnen gleich. Entfernt man jemanden nur aus einer Gruppe, wird der Vergleich wieder zu „aktiv gegen alle“.
Der Ansatz hat seinen Preis: Er verwässert den Effekt etwas, weil in der Testgruppe Menschen ohne Nachricht bleiben. Dafür geht der Fehler in die sichere Richtung: Die Schätzung ist vorsichtig statt aufgebläht. Für eine Budgetentscheidung ist das genau richtig.
Das Ergebnis:
- +4,8 % Kauf-Conversion über die gesamte Testgruppe statt +77 %.
- +7,2 % bei denen, die die Nachricht tatsächlich erhalten haben. Die Zustellstatus stammen aus der Analytics des Kunden, an die der Versanddienst sie übermittelt. Diese Zahl ist weniger verlässlich: Die Zustellung ist nur in der Testgruppe sichtbar, und in der Kontrollgruppe gibt es keine „passenden“ Personen zum Vergleich. Deshalb beruhte die Entscheidung auf +4,8 %.
Zusätzlich haben wir einen segmentierten A/B-Test für SMS durchgeführt. Bei Kunden mit hohem Warenkorb, die lange nichts gekauft hatten, holten SMS Käufer deutlich besser zurück als im Durchschnitt der Basis.
Fazit für das Business: Die Schätzung ist bescheidener, aber man kann sich darauf stützen. Auf +77 % baut man leicht ein Budget für einen Effekt, den es nicht gibt.
Wenn das Konfidenzintervall die Null einschließt
Ein Detail, das Fallstudien meist verschweigen: Der Umsatzeffekt ist positiv, aber grenzwertig, das Konfidenzintervall schließt die Null ein.
Ein Test liefert keine exakte Zahl, sondern eine Spanne, in der der wahre Effekt höchstwahrscheinlich liegt. Liegt die ganze Spanne über null, bringen die Kampagnen Geld. Schließt sie die Null ein, kann man nicht ausschließen, dass es gar keinen Umsatzeffekt gibt, selbst wenn der Mittelwert ordentlich aussieht.
Beim Umsatz ist das häufig: Er schwankt stark von Kunde zu Kunde, und einige große Käufe in einer Gruppe verschieben den Mittelwert stärker als alle Kampagnen eines Monats. Deshalb ist ein kleiner Umsatzeffekt schwerer nachzuweisen als ein Conversion-Effekt.
Wir haben den Kunden selbst darauf hingewiesen und sofort einen Wiederholungstest geplant, mit einer Kontrollgruppe, die nach denselben Regeln bereinigt wird wie die Testgruppe. Bestätigt er den Effekt, steht die Entscheidung auf festem Boden. Wenn nicht, bleibt das Geld im Unternehmen.
Fazit für das Business: Ein ehrliches „Es gibt einen Effekt, aber wir sind nicht sehr sicher“ kostet weniger als selbstbewusstes Skalieren auf einem Fehler. Zeigt man Ihnen eine einzige Zahl ohne Spanne, fragen Sie nach der Spanne.
Was das Unternehmen bekommen hat
- Eine belastbare Schätzung, wie viel das CRM über „hätten ohnehin gekauft“ hinaus bringt. Sie hängt nicht mehr davon ab, wen der Versanddienst aussortiert hat.
- Ein Kriterium für die Skalierung: Eine Kampagne wird nur ausgeweitet, wenn sie nach Rabatten und Kanalkosten Marge bringt. Steigende Conversion allein sagt nichts über Geld. Eine Kampagne mit Rabattcode kann den Absatz steigern und trotzdem Verlust machen, wenn den Rabatt vor allem Kunden erhalten, die ohnehin gekauft hätten.
- Eine Antwort darauf, wen man anschreibt. Jedes Segment lässt sich einzeln entscheiden: Gibt es Uplift, und deckt er die Kosten? Eine Erinnerung an jemanden, der ohnehin jede Woche kauft, bringt kaum etwas, kann aber einen Kunden zurückholen, der seit einem halben Jahr verschwunden ist.
Details zum Fall in den Fallstudien, und wie wir Kampagnen messen, auf der Seite CRM-Inkrementalität.
Wie Sie Ihren Bericht in einer Stunde prüfen
Wenn Sie bereits einen Kampagnenbericht mit Kontrollgruppe haben, zeigen drei Abfragen, ob Sie ihm trauen können. Die Tabellennamen sind Beispiele: Sie brauchen eine Zuordnungstabelle (Kunde, Gruppe, ob der Filter des Dienstes bestanden wurde) und eine Bestelltabelle.
Schritt 1. Gruppengrößen in jedem Schritt. Vergleichen Sie, wie viele Kunden jeder Gruppe zugeordnet wurden und wie viele nach dem Hochladen in den Dienst übrig blieben.
SELECT grp,
       COUNT(*)                                     AS assigned,
       COUNT(*) FILTER (WHERE passed_filter)        AS after_filter,
       ROUND(100.0 * COUNT(*) FILTER (WHERE passed_filter) / COUNT(*), 1) AS kept_pct
FROM crm_test_assignment
GROUP BY grp;
Unterscheidet sich der verbliebene Anteil zwischen den Gruppen um mehr als ein paar Prozentpunkte, darf man die „Verbliebenen“ nicht vergleichen.
Schritt 2. Balance vor dem Start. Vergleichen Sie das Verhalten der Gruppen in den 90 Tagen vor dem Test: Anteil der Käufer und durchschnittliche Bestellzahl sollten fast gleich sein.
SELECT a.grp,
       COUNT(*)                              AS clients,
       AVG((COALESCE(o.orders, 0) > 0)::int) AS share_buyers_90d,
       AVG(COALESCE(o.orders, 0))            AS avg_orders_90d
FROM crm_test_assignment a
LEFT JOIN (
  SELECT client_id, COUNT(*) AS orders
  FROM orders
  WHERE order_date >= DATE '2026-03-01' - INTERVAL '90 days'
    AND order_date <  DATE '2026-03-01'   -- Teststart (Beispiel)
  GROUP BY client_id
) o USING (client_id)
GROUP BY a.grp;
Unterschieden sich die Gruppen schon vor der ersten Nachricht, ist der Effekt von Anfang an verzerrt.
Schritt 3. Effekt nach der ursprünglichen Aufteilung. Berechnen Sie die Conversion für alle Zugeordneten jeder Gruppe, ohne Filter des Dienstes, und vergleichen Sie sie mit der Zahl im Bericht.
SELECT a.grp,
       COUNT(*)                                AS clients,
       AVG((COALESCE(o.orders, 0) > 0)::int)   AS conversion
FROM crm_test_assignment a
LEFT JOIN (
  SELECT client_id, COUNT(*) AS orders
  FROM orders
  WHERE order_date BETWEEN DATE '2026-03-01' AND DATE '2026-03-31'  -- Testzeitraum (Beispiel)
  GROUP BY client_id
) o USING (client_id)
GROUP BY a.grp;
Ist der Uplift hier deutlich kleiner als im Bericht, ist der Bericht überhöht. Für eine Entscheidung ergänzen Sie ein Konfidenzintervall und rechnen den Uplift in Marge um.
Checkliste: 7 Prüfungen für einen Kampagnenbericht
Diese Fragen können Sie Ihrem Team oder Dienstleister stellen.
- Die Gruppengrößen entsprechen dem Plan. Geplant war 50 zu 50, im Bericht sind die Gruppen deutlich verschieden? Dann sind unterwegs Kunden verloren gegangen, und kaum zufällig.
- Die Gruppen waren vor dem Start ähnlich. Vergleichen Sie die Kaufhistorie vor dem Test.
- Es ist klar, wo Kontakte gefiltert werden. Werden Kunden ohne Einwilligung, mit ungültigen Kontakten und Abgemeldete vor oder nach der Aufteilung aussortiert?
- Für beide Gruppen gelten dieselben Regeln. Jeder Filter der Testgruppe muss auch auf die Kontrollgruppe angewendet werden, selbst wenn sie nichts erhält.
- Vergleich nach der ursprünglichen Aufteilung. Alle der Testgruppe Zugeordneten gegen alle der Kontrollgruppe Zugeordneten. Signifikanz ersetzt diese Prüfung nicht.
- Der Bericht zeigt eine Spanne, nicht eine Zahl. Schließt das Konfidenzintervall die Null ein, ist der Effekt nicht bewiesen.
- Der Effekt ist in Marge berechnet. Ziehen Sie Rabatte und Kanalkosten ab. Bleibt nichts übrig, gibt es nichts zu skalieren.
Fällt auch nur eine Prüfung durch, ist es zu früh, dem Bericht zu trauen. Das heißt nicht, dass die Kampagnen nicht wirken. Es heißt, dass Sie es noch nicht wissen.
Ein Fehler um das 16-Fache braucht weder böse Absicht noch eine falsche Formel: Ein Filter an der falschen Stelle genügt. Eine ähnliche Falle bei Rabatten beschreibt der Artikel „Rabatt im Onlinespiel“.
Wenn Sie an Ihrem Kampagnenbericht zweifeln, erzählen Sie uns von Ihrer Aufgabe: In einem kostenlosen 30-minütigen Gespräch schauen wir, ob Sie ihm trauen können und was Sie zuerst prüfen sollten.
Häufige Fragen
Wie groß sollte eine Kontrollgruppe für CRM-Kampagnen sein?
Das hängt von der Größe Ihrer Kundenbasis und dem Effekt ab, den Sie erkennen wollen. Je kleiner der erwartete Uplift, desto größer die Kontrollgruppe. Für einen kleinen Effekt auf die Conversion braucht man meist Zehntausende Kunden pro Gruppe. Berechnen Sie die Größe vor dem Start, sonst halten Sie Kunden einen Monat lang zurück und sehen trotzdem keinen Unterschied.
Kann man den Effekt von CRM-Kampagnen ohne Kontrollgruppe messen?
Der Bericht des Versanddienstes zeigt, wie viele Käufe die Empfänger getätigt haben, aber nicht, wie viele auch ohne Nachricht passiert wären. Vorher-nachher-Vergleiche werden durch Saisonalität und Aktionen verzerrt. Ohne Kontrollgruppe überschätzen Sie den Effekt sehr wahrscheinlich, besonders bei Stammkunden.
Worin unterscheidet sich eine globale Kontrollgruppe von der Kontrollgruppe einer einzelnen Kampagne?
In der globalen Kontrollgruppe erhalten Kunden während des gesamten Tests über keinen Kanal Nachrichten. Sie zeigt den Effekt des gesamten CRM. Die Kontrollgruppe einer einzelnen Kampagne misst nur diese Kampagne, und das Ergebnis vermischt sich mit anderen Nachrichten, die der Kunde parallel erhalten hat.
Was ist Intention-to-treat und warum zählen Kunden mit, die nichts erhalten haben?
Intention-to-treat vergleicht die Gruppen so, wie der Zufall sie gebildet hat: alle der Testgruppe Zugeordneten gegen alle der Kontrollgruppe Zugeordneten. Entfernt man nicht zugestellte Kunden nur aus der Testgruppe, sind die Gruppen nicht mehr vergleichbar, und der Effekt wird überschätzt. Die Schätzung nach der ursprünglichen Aufteilung ist etwas vorsichtiger, aber verlässlich.